
Google Cloud ouvre en préversion publique limitée CodeMender, un agent de sécurité capable d’analyser un dépôt, de vérifier qu’une vulnérabilité est réellement exploitable et de générer un correctif testé. Le produit, issu des recherches de Google DeepMind, veut réduire le temps qui sépare une alerte de son traitement par les développeurs.
La promesse va plus loin qu’un scanner statique ou qu’une simple suggestion de code. CodeMender peut construire le logiciel, produire un exploit de démonstration dans un environnement isolé, proposer un diff puis tester ce changement. Cette autonomie augmente aussi le niveau de risque : l’agent exécute des commandes et manipule du code sensible, ce qui impose un sandbox strict et une validation humaine.
La réponse rapide
| Question | Réponse |
|---|---|
| Que fait CodeMender ? | Il recherche, vérifie et corrige des vulnérabilités dans un code source. |
| Est-il disponible pour tous ? | Non. La préversion publique reste limitée à certains clients Google Cloud. |
| Applique-t-il les correctifs tout seul ? | Google indique que les développeurs doivent examiner et approuver les changements avant le commit. |
| Où les exploits sont-ils exécutés ? | Dans un sandbox ou une machine isolée gérée par le client. |
| Le dépôt complet est-il envoyé à Google ? | La CLI transmet des extraits ciblés et des résultats, mais pas un clonage intégral autonome du dépôt. |
| Remplace-t-il une équipe AppSec ? | Non. Il accélère l’analyse et le correctif, sans remplacer la modélisation des menaces, la revue et la décision de déploiement. |
Trois étapes : trouver, prouver, corriger
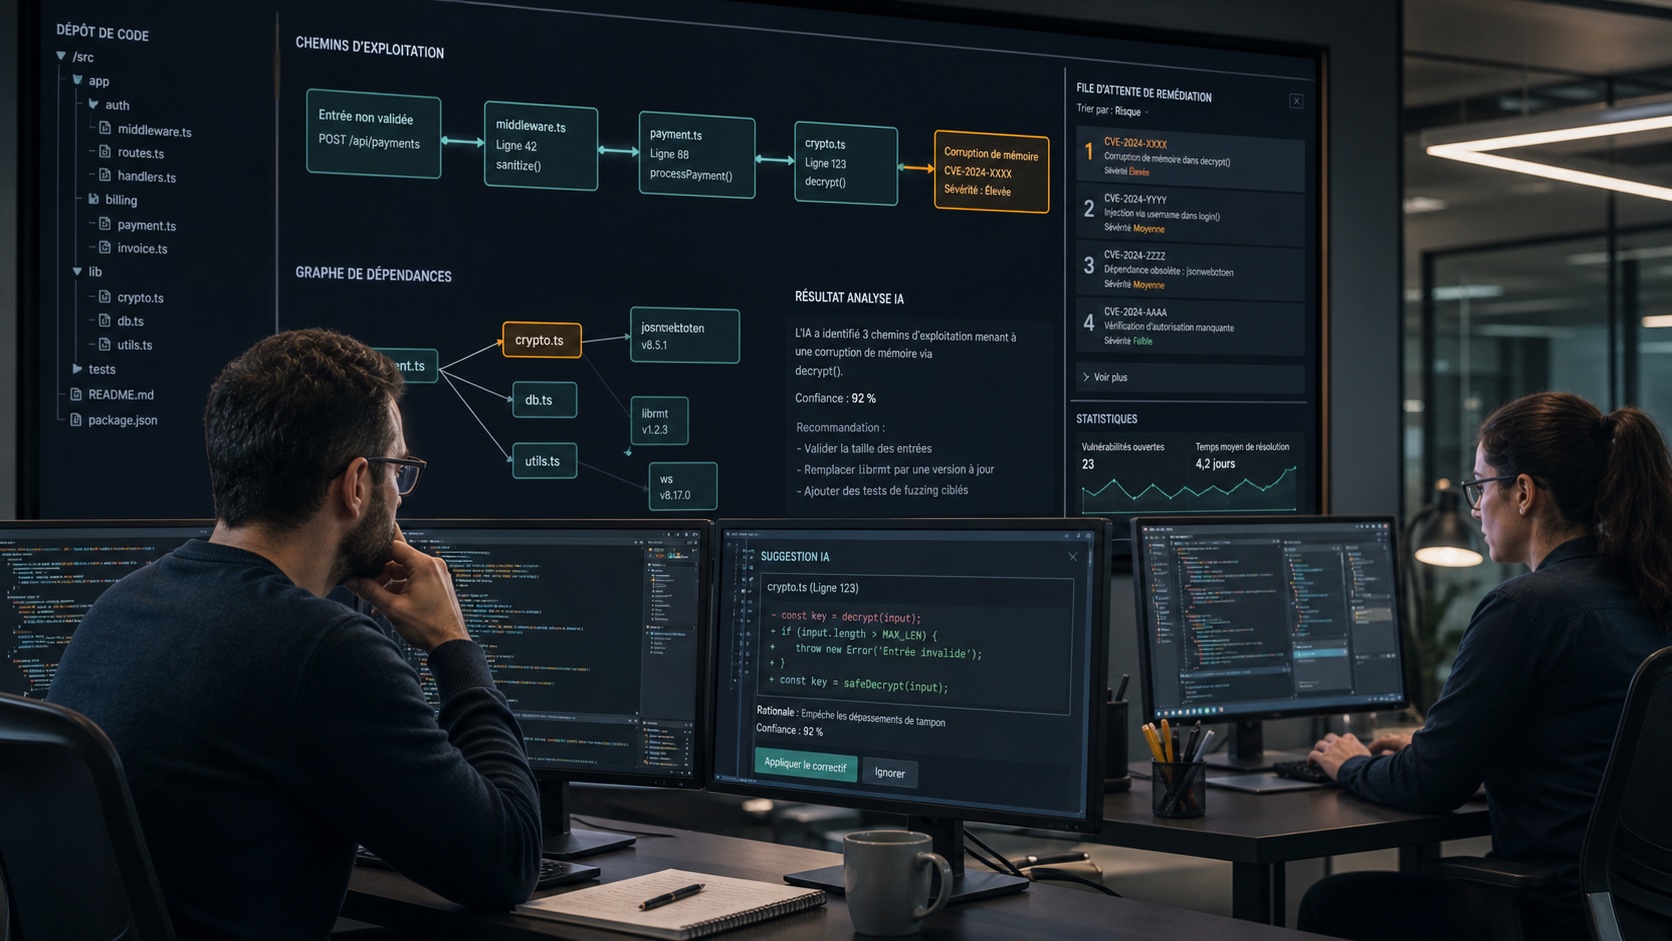
La première étape recherche des classes de failles comme les corruptions mémoire, injections, erreurs cryptographiques, problèmes Web ou manipulations dangereuses de données. L’agent combine un modèle de langage, des instructions spécialisées et des outils d’analyse pour suivre les flux de contrôle et de données au-delà d’une correspondance de motifs.
La deuxième étape est la plus distinctive. CodeMender tente de construire un exploit de démonstration et de l’exécuter dans l’environnement isolé du client. Une alerte confirmée par une exécution peut être priorisée devant un signal théorique. Cette méthode vise à réduire le temps perdu sur les faux positifs, sans prouver pour autant l’absence d’autres chemins d’attaque.
Enfin, l’agent génère un patch, lance les tests et présente un diff au développeur. Google utilise également une évaluation par modèle pour vérifier que le changement conserve le comportement attendu. Cette vérification supplémentaire ne constitue pas une preuve formelle : les tests existants, la revue humaine et le déploiement progressif restent nécessaires.
Un agent hébergé, une exécution locale
CodeMender repose sur deux composants. Le raisonnement principal est assuré par un système multi-agent hébergé dans Gemini Enterprise Agent Platform. Une CLI installée chez le client sert d’interface et de daemon pour lire les fichiers ciblés, compiler, lancer les tests et exécuter les démonstrations.
Google précise que le service ne clone pas de manière indépendante l’intégralité du dépôt. La CLI transmet néanmoins au service hébergé des extraits de code, des informations sur les vulnérabilités, des propositions de patch, des résultats de commandes et de la télémétrie. Une entreprise doit donc classifier ses dépôts et vérifier ses obligations avant d’autoriser l’outil sur du code sensible.
La documentation annonce une conservation des données de session pouvant atteindre sept jours, avec une suppression explicite possible. Google affirme ne pas utiliser le code client pour entraîner les poids des modèles. Les contrôles IAM, les périmètres VPC Service Controls et les journaux doivent compléter ces engagements contractuels.
Pourquoi l’exécution d’exploits change le risque
Prouver une faille exige de réaliser une action proche de celle d’un attaquant. Même si l’objectif est défensif, un exploit peut faire planter un service, corrompre des données ou déclencher un comportement inattendu. Il ne doit jamais être exécuté directement sur un poste de travail contenant des secrets ou sur une infrastructure de production.
Google active par défaut un sandbox local au niveau des processus et recommande une machine virtuelle ou un conteneur isolé lorsque les protections sont désactivées. Une politique mature devrait aller plus loin : image jetable, réseau sortant limité, secrets factices, données synthétiques, quotas de ressources et destruction de l’environnement après l’analyse.
L’agent lui-même doit être considéré comme un composant privilégié. Il lit du code potentiellement hostile, reçoit des instructions présentes dans les fichiers et peut lancer des outils. Les équipes doivent donc envisager la prompt injection dans le dépôt, les dépendances piégées et les commandes générées comme des scénarios de menace à part entière.
Quels langages et quels modèles ?
La documentation cite C/C++, Go, Java, Python, Ruby, Rust et TypeScript/JavaScript, avec des frameworks courants comme Django, Flask, React, Spring Boot et Express. Cette liste décrit une couverture annoncée, pas une qualité uniforme pour chaque langage, système de construction ou architecture.
CodeMender prend en charge plusieurs modèles, dont Gemini 3.5 Flash par défaut. La variante spécialisée Gemini 3.5 Flash Cyber reste réservée à un petit nombre de gouvernements et de partenaires de confiance. Cette restriction reflète le caractère dual de modèles capables d’identifier et de valider rapidement des vulnérabilités.
Le coût dépend notamment des jetons consommés. Une analyse profonde d’un grand dépôt peut mobiliser beaucoup de contexte, de commandes et d’itérations. Avant un déploiement large, il faut mesurer le coût par vulnérabilité confirmée et par correctif accepté, plutôt que le nombre brut d’alertes produites.
Comment l’évaluer sans fragiliser la production
Un pilote devrait commencer sur un dépôt non critique possédant une bonne suite de tests et des vulnérabilités historiques connues. L’équipe peut alors mesurer le rappel, les faux positifs, la qualité des exploits, le taux de patchs acceptés, les régressions et le temps humain économisé.
Les correctifs doivent suivre le même parcours que ceux écrits par un humain : branche dédiée, revue obligatoire, analyse de dépendances, tests automatisés, environnement de préproduction et déploiement progressif. L’origine IA ne justifie ni un privilège particulier, ni un rejet automatique.
Il faut également séparer les rôles. L’agent peut proposer et vérifier ; le système de contrôle de version impose les règles ; un développeur et, pour les changements sensibles, un spécialiste sécurité approuvent. Les journaux doivent conserver le modèle, les outils, les commandes et les résultats ayant conduit au patch.
Ce que CodeMender ne résout pas
Un outil centré sur le code ne connaît pas automatiquement toutes les hypothèses métier. Une autorisation trop large, un processus de remboursement fraudable ou une mauvaise séparation des responsabilités peuvent être parfaitement valides pour le compilateur tout en restant dangereux.
Il ne remplace pas non plus la gestion des dépendances, la configuration du cloud, les secrets, la surveillance en production ou la réponse à incident. Une application peut être corrigée dans son dépôt et rester exposée à cause d’une image non reconstruite ou d’un service jamais redéployé.
CodeMender illustre toutefois un changement concret de la sécurité applicative : l’IA ne se contente plus de commenter une alerte, elle peut essayer l’attaque et préparer la correction. La bonne question n’est donc pas de savoir si l’agent peut écrire un patch, mais si l’organisation peut encadrer, vérifier et déployer ce patch avec une traçabilité au moins équivalente à celle d’un changement humain.
La discussion
Commentaires
Chargement des commentaires…