
Architecture data pour l'IA : qualité, RAG, pipelines et exploitation
De la source à l'évaluation, les composants nécessaires pour alimenter une application IA avec des données fiables, observables et gouvernées.
dataarchitectureragqualitémlops
Catégorie
Bases de données, pipelines, analytics, ML ops et qualité des données.
Bases de données, pipelines, analytics et MLOps sont analysés comme les composants d'un même système. Nous couvrons leur fiabilité, leur gouvernance et la qualité nécessaire pour produire des décisions utiles.
Guide de référence
De la source à l'évaluation, les composants nécessaires pour alimenter une application IA avec des données fiables, observables et gouvernées.
Cinq optimisations Rust ont réduit de 56 % l’empreinte d’une entrée DNS chez Cloudflare. Les leçons applicables aux systèmes à très grande échelle.
ClickHouse 26.7 détaille enfin le coût réel des requêtes et optimise les agrégations Top-N ainsi que la recherche vectorielle quantifiée.
Cloudflare ouvre la bêta de Radar Researcher, un assistant qui interroge les données réseau en langage naturel et produit des graphiques vérifiables.
etcd 3.7 apporte RangeStream et plusieurs optimisations, mais retire des composants historiques. Voici la procédure avant une migration Kubernetes.
PostgreSQL 19 Beta 2 précise les nouveautés attendues à l'automne. Performances, observabilité et compatibilité : voici un plan de test sans risque.
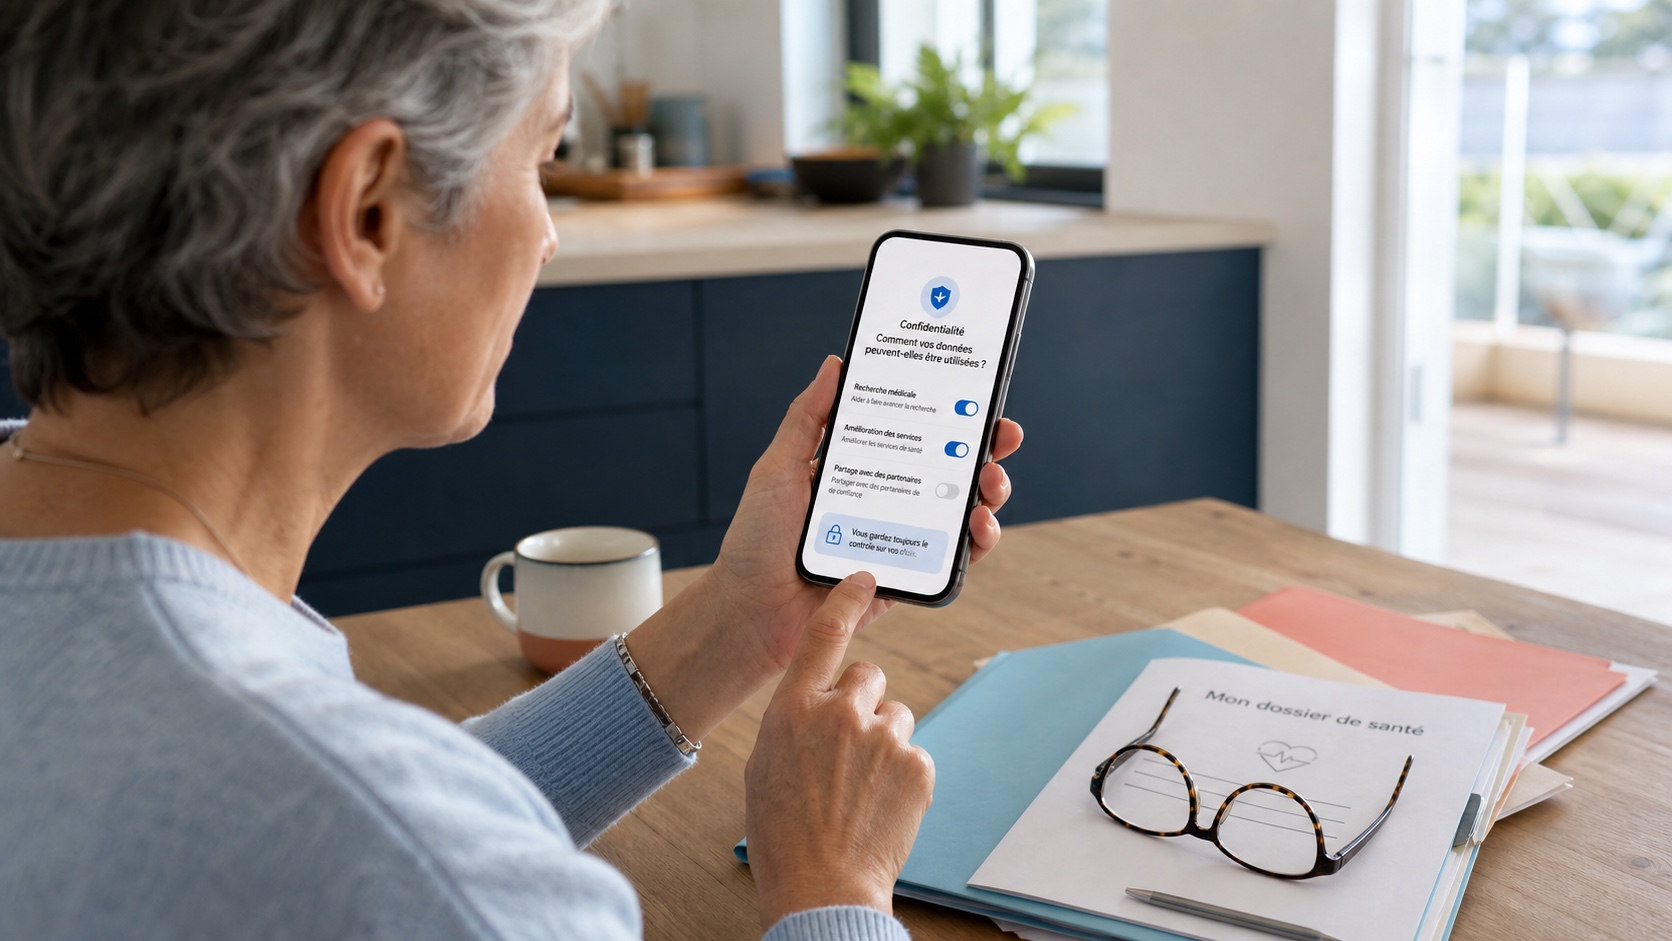
Le projet de recherche de Doctolib fondé sur des données de santé démarre en août. Données concernées, pseudonymisation et droit d'opposition : ce qu'il faut vérifier.
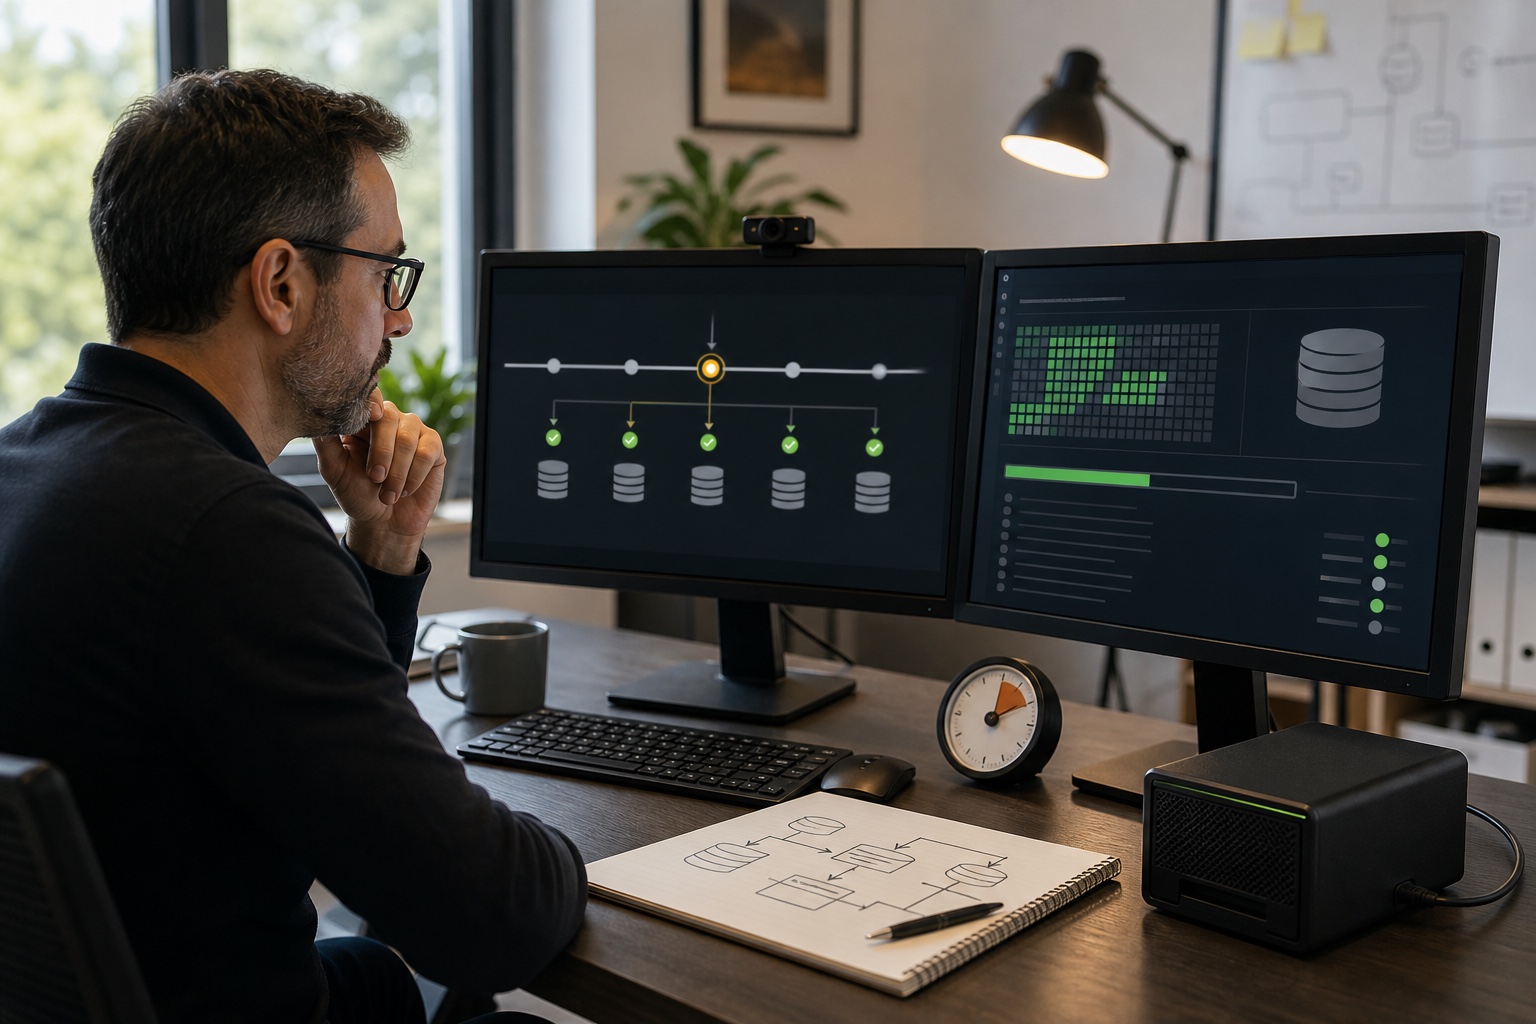
PostgreSQL, MySQL, Docker et PITR : une méthode opérationnelle pour choisir ses sauvegardes, tester une restauration et prouver ses objectifs RPO/RTO.
Ingestion, recherche hybride, reranking, citations et métriques : une méthode complète pour construire un RAG fiable et savoir s'il peut passer en production.
PostgreSQL 18 apporte des améliorations techniques qui touchent directement la performance, les migrations et les modèles de données.
Iceberg apporte snapshots, évolution de schéma et partitionnement caché aux grands ensembles analytiques.
Ajouter une base vectorielle ne rend pas un assistant fiable. Les documents, chunks et métadonnées déterminent souvent le résultat.
Doublons, champs incomplets et définitions contradictoires deviennent plus dangereux quand un modèle les reformule avec assurance.
Les équipes suivent les APIs avec traces et métriques. Les pipelines data méritent la même exigence pour comprendre les retards et erreurs.
La couche sémantique promet des indicateurs partagés entre BI, notebooks et IA. Elle demande surtout une gouvernance claire.
Le streaming est puissant, mais il ajoute coûts et complexité. Le bon rythme dépend de la décision à prendre.
Les équipes veulent donner plus de contexte aux modèles. La meilleure protection reste parfois de ne pas envoyer la donnée.
Les données synthétiques peuvent protéger la confidentialité et accélérer les tests. Elles doivent rester comparées au réel.
Latence et disponibilité ne suffisent pas. En production, un modèle peut rester en ligne tout en devenant mauvais.