
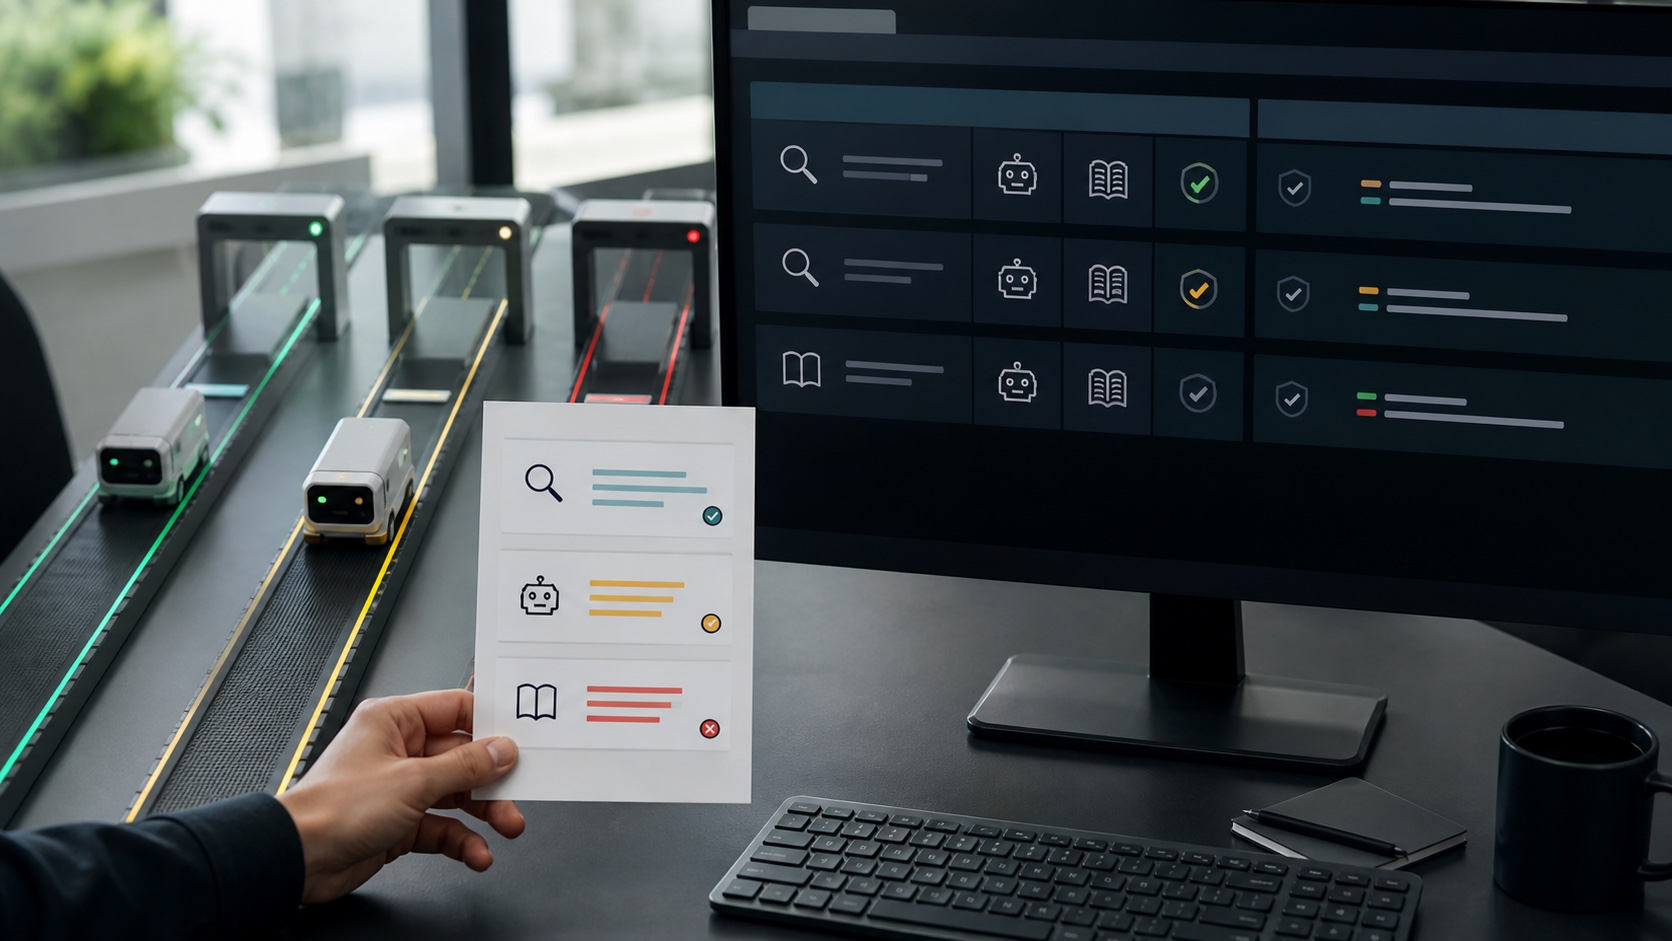
Cloudflare lance Bot Preference Sync, une fonction qui reporte dans robots.txt les préférences déjà définies dans son tableau de bord pour les robots de recherche, les agents et l’entraînement des modèles. L’objectif est d’éviter qu’un site déclare une règle tout en appliquant une politique réseau différente.
La réponse rapide
| Couche | Rôle |
|---|---|
robots.txt | Déclare ce que l’éditeur souhaite autoriser aux robots coopératifs. |
| Politique Cloudflare | Autorise, limite ou bloque techniquement les requêtes identifiées. |
| Bot Preference Sync | Maintient la déclaration cohérente avec les préférences du tableau de bord. |
La synchronisation réduit les erreurs de configuration. Elle ne garantit pas qu’un robot malveillant respectera robots.txt, ni que tous les crawlers seront correctement identifiés.
Trois usages qui ne doivent plus être confondus
Cloudflare distingue les robots destinés à la recherche, ceux qui agissent pour le compte d’un utilisateur et ceux qui collectent des données pour entraîner un modèle. Un éditeur peut vouloir rester indexé dans un moteur, accepter un agent qui consulte une page à la demande et refuser l’utilisation de l’ensemble du site pour l’entraînement.
Cette granularité est plus utile qu’un choix « tous les robots IA » ou « aucun ». Elle dépend toutefois de la manière dont chaque opérateur déclare son bot et de la capacité du fournisseur réseau à reconnaître son trafic.
Déclarer n’est pas bloquer
robots.txt repose historiquement sur la coopération. Un crawler peut l’ignorer, changer de user-agent ou passer par une adresse difficile à attribuer. Une règle générée automatiquement reste donc une préférence publique, pas une barrière de sécurité.
Pour faire respecter une décision, il faut une couche d’exécution : règles WAF, gestion des bots, limitation de débit ou authentification. Le risque inverse existe aussi. Un blocage trop large peut toucher un moteur légitime, un outil d’accessibilité ou un partenaire métier.
Attention au fichier déjà personnalisé
Avant d’activer une synchronisation, sauvegardez le robots.txt actuel et identifiez qui le produit : application, CDN, plugin SEO ou déploiement statique. Vérifiez les règles propres aux répertoires, les sitemaps et les exceptions pour les moteurs classiques.
Après chaque changement, récupérez le fichier depuis plusieurs régions et contrôlez la réponse réellement servie. Un cache, une règle de redirection ou une autre couche peut masquer la version attendue.
Une politique à documenter
Le choix d’accepter l’entraînement ne relève pas uniquement de l’équipe infrastructure. Il concerne les droits sur les contenus, les contrats avec les auteurs, la stratégie d’acquisition et le référencement. Documentez le responsable de la décision, les catégories de bots et la date de révision.
Conservez aussi des métriques : volume de crawling, codes de réponse, bande passante et impact sur l’indexation. Une politique cohérente doit pouvoir être évaluée, pas seulement affichée dans un tableau de bord.
Bot Preference Sync résout un vrai problème de divergence entre déclaration et exécution. Il simplifie la gouvernance, mais ne transforme pas robots.txt en contrôle d’accès et ne dispense pas d’observer le trafic réel.
La discussion
Commentaires
Chargement des commentaires…