
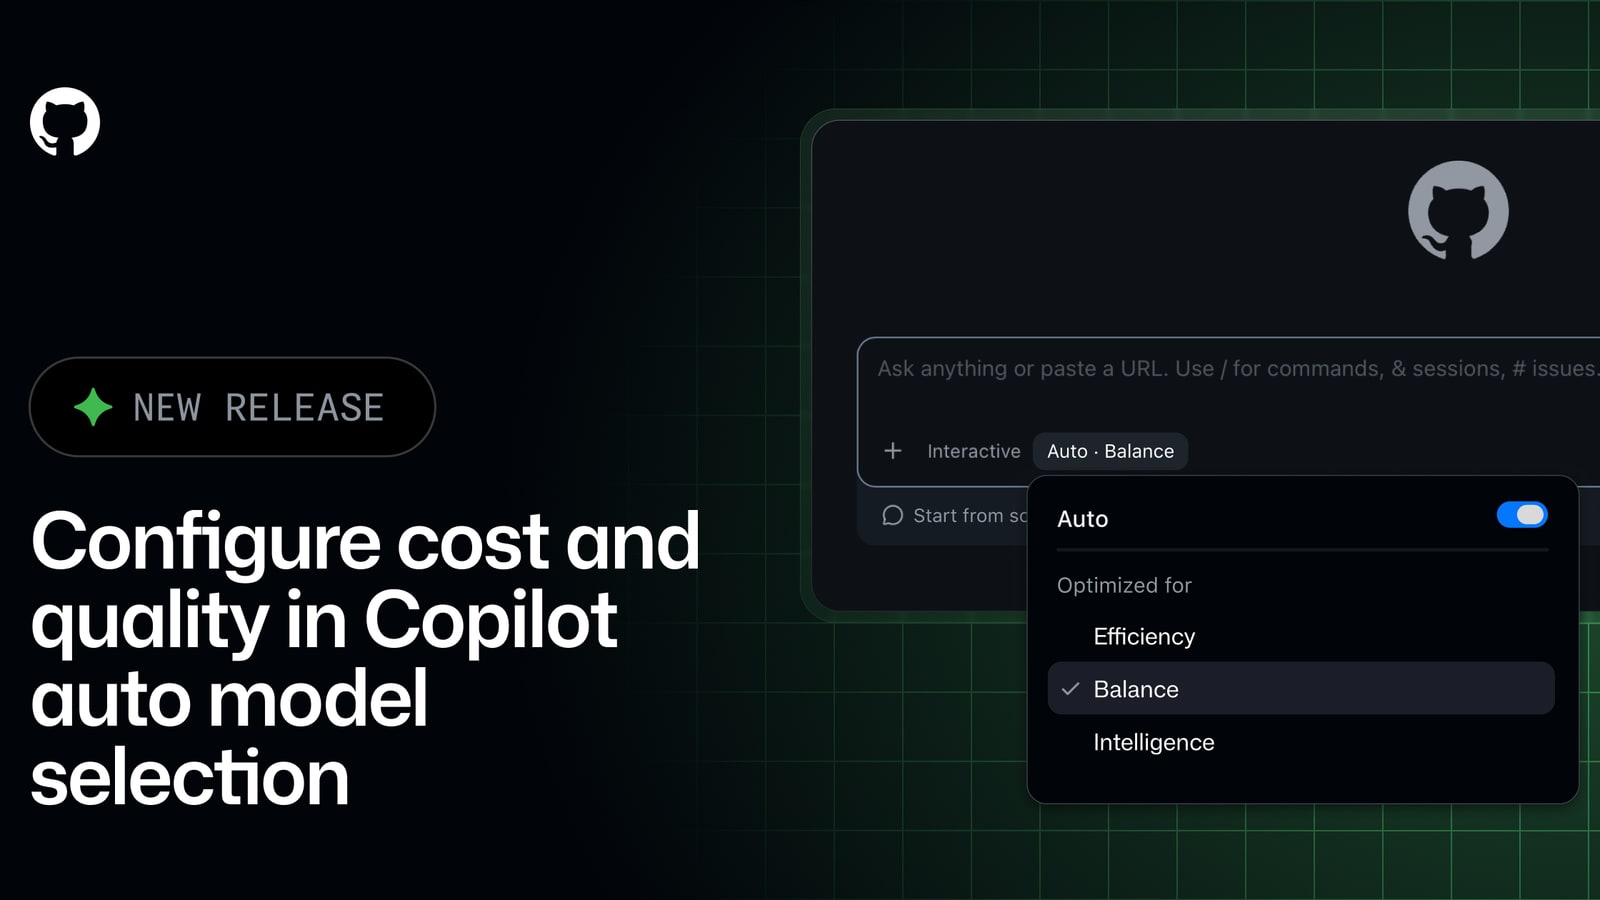
GitHub enrichit Copilot Auto avec trois niveaux : Efficiency, Balance et Intelligence. Le système continue de choisir un modèle pour chaque requête, mais l'utilisateur indique désormais la priorité générale qu'il souhaite donner au coût, à la vitesse ou à la qualité.
La réponse rapide
| Niveau | Priorité |
|---|---|
| Efficiency | Réduire le coût et répondre vite. |
| Balance | Arbitrer coût, qualité et latence. |
| Intelligence | Favoriser les tâches complexes. |
Un réglage, pas un modèle fixe
Les trois niveaux utilisent le même catalogue de modèles. Même en mode Intelligence, une demande simple comme ajouter une docstring peut être envoyée à un petit modèle. Le niveau influence l'arbitrage ; il ne garantit donc ni un nom de modèle ni un prix constant.
La facturation reste liée au choix réel
L'usage est facturé selon le modèle finalement sélectionné. Les abonnés payants conservent la remise de 10 % sur l'usage Auto. Une équipe doit suivre ses consommations avant d'activer Intelligence partout : la meilleure qualité théorique n'est pas nécessaire pour chaque correction.
Où le réglage arrive
Le déploiement concerne VS Code, Copilot CLI et l'application GitHub Copilot. Pour comparer proprement, gardez un type de tâche stable, mesurez le coût, le délai et la qualité de la revue, puis choisissez une valeur par défaut adaptée au dépôt.
Un premier pas vers un routage explicable
Le routage automatique devient plus utile quand ses compromis sont visibles. GitHub promet davantage de personnalisation. Il faudra maintenant exposer assez d'informations après chaque réponse pour que les équipes comprennent ce qu'elles paient et pourquoi Auto a changé de modèle.
La discussion
Commentaires
Chargement des commentaires…