
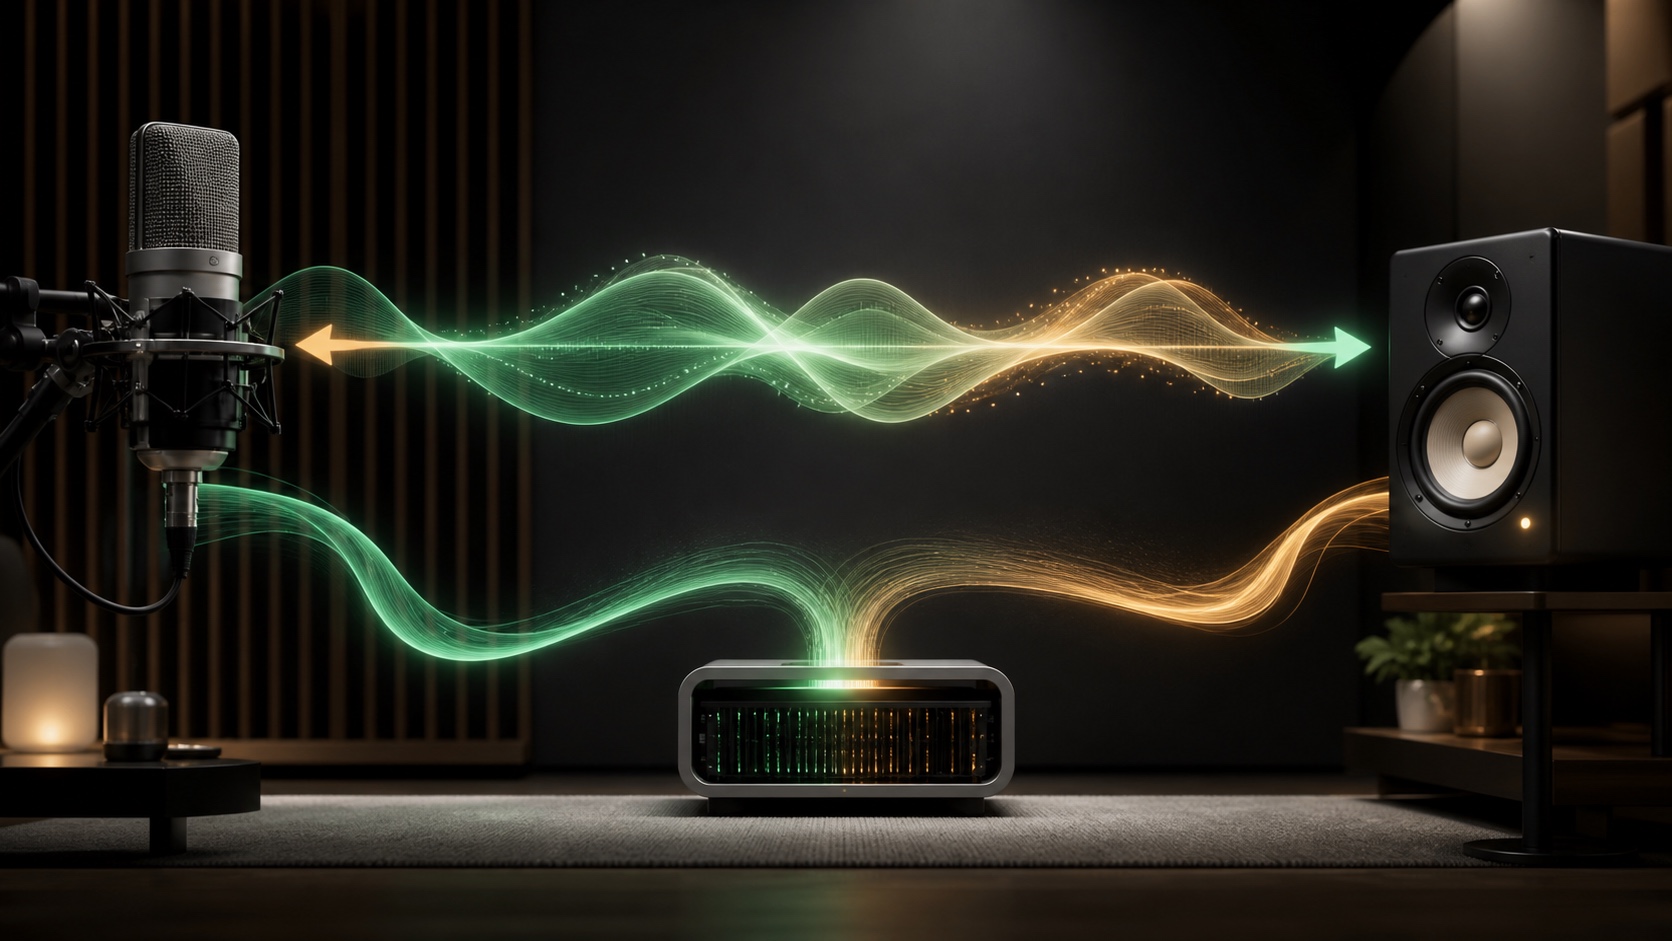
Une conversation naturelle supporte les hésitations, les interruptions et les petits signes d’écoute. GPT-Live tente de reproduire ce rythme avec une architecture full duplex : le modèle reçoit l’audio tout en générant sa réponse et décide plusieurs fois par seconde s’il doit parler, attendre, interrompre ou appeler un outil. OpenAI sépare aussi la conversation rapide du raisonnement lourd, confié en arrière-plan à un modèle frontière.
La difficulté n’est donc pas seulement d’obtenir une bonne voix. Il faut maintenir un flux audio à faible latence, conserver l’état pendant une longue session, déplacer cette session entre accélérateurs et faire revenir une recherche sans provoquer un silence gênant.
La réponse rapide
| Question | Réponse |
|---|---|
| Que signifie full duplex ? | Le système écoute et parle simultanément au lieu d’alterner des tours stricts. |
| Pourquoi utiliser deux modèles ? | GPT-Live gère le rythme tandis qu’un modèle plus puissant cherche ou raisonne. |
| Quel transport est utilisé ? | WebRTC fournit le flux média temps réel et résiste aux pertes de paquets. |
| Comment garder une longue conversation ? | Le contexte est compacté et transféré vers une instance préparée en parallèle. |
| L’API est-elle déjà disponible ? | OpenAI annonce une API à venir ; le système équipe déjà ChatGPT Voice. |
Du pipeline en trois étapes au modèle audio continu
Les premiers assistants vocaux enchaînaient transcription, modèle de langage et synthèse. Chaque étape ajoutait du délai et pouvait perdre une information de ton ou de rythme. Les modèles audio de génération suivante réduisaient ce délai, mais attendaient encore la fin d’un tour détectée par le silence.
GPT-Live traite le flux en continu. Une pause ne signifie plus automatiquement que l’utilisateur a terminé. Le modèle peut produire un acquiescement bref sans transformer celui-ci en réponse complète, ou rester silencieux lorsqu’on lui demande simplement d’écouter.
Cette liberté complique la journalisation. L’interface, les outils de sécurité et les analyses attendent toujours des messages distincts. Le serveur construit donc une vue provisoire à partir des transcriptions partielles et du timing, puis finalise un historique lorsque l’attribution du tour devient suffisamment fiable.
WebRTC maintient le son sur une route prioritaire
OpenAI utilise WebRTC comme fondation de transport. Le protocole sait composer avec les paquets perdus, la dérive d’horloge et les changements de connexion. Il peut étirer légèrement un segment arrivé en retard puis accélérer pour retrouver le temps réel.
L’objectif annoncé est une réponse inférieure à la seconde. Cela demande de limiter les buffers et les opérations bloquantes sur tout le chemin, pas seulement d’accélérer l’inférence. Un serveur média saturé ou une capacité trop éloignée géographiquement peut annuler le gain d’un modèle rapide.
Pour le démarrage, OpenAI a travaillé sur WARP, un ensemble de propositions qui réduit plusieurs négociations WebRTC de six allers-retours réseau à un. Instant Connect prépare également certains paramètres avant la création effective de la session. Dans le meilleur cas, le premier paquet UDP suffit à matérialiser le chemin média côté serveur.
Parler vite et réfléchir profondément deviennent deux tâches
GPT-Live assure les réponses immédiates. Lorsqu’une question demande une recherche, un outil ou davantage de raisonnement, il délègue à GPT-5.5 en arrière-plan. Le modèle vocal peut garder l’échange vivant pendant que le résultat est préparé.
Le serveur crée à l’avance une session pour le modèle de raisonnement et préremplit le contexte initial. L’affinité de session et le cache de prompt évitent de recommencer tout le traitement à chaque délégation. Le temps des outils, le niveau de raisonnement et la taille de sortie restent inclus dans le budget de latence.
Cette architecture donne une leçon générale aux agents : une interface temps réel ne doit pas attendre la tâche la plus lente. Elle a besoin d’un canal réactif, d’un travail asynchrone et d’un moyen clair d’insérer le résultat sans tromper l’utilisateur sur son état.
Le contexte doit survivre aux changements d’instance
Une conversation longue fait grossir le contexte tandis que les instances de modèle apparaissent et disparaissent avec la charge. OpenAI prépare une nouvelle instance en parallèle, lui transmet l’état, exécute temporairement les deux puis bascule lorsque la remplaçante est prête.
Le même mécanisme sert au compactage. Résumer l’historique invalide le cache de clés et valeurs utilisé par l’attention. Plutôt que de bloquer la voix pendant sa reconstruction, le système compacte et préremplit ailleurs, puis effectue une transition sans couper le média.
La charge se mesure en sessions, pas seulement en requêtes
Les tests en miroir sur du trafic réel ont montré qu’un benchmark GPU ne suffisait pas. Une session vocale reste ouverte, envoie continuellement des trames et sollicite CPU, réseau, files et stockage d’état. Un composant périphérique peut saturer avant l’accélérateur et faire croître toute la latence.
OpenAI a donc évalué le nombre de sessions simultanées dont chaque trame respecte son échéance. Les longues conversations, reconnexions et déconnexions ordinaires ont révélé des problèmes que des tests courts ne reproduisaient pas.
Ce que les développeurs peuvent retenir
Une future API GPT-Live ne supprimera pas les responsabilités de l’application. Il faudra gérer le consentement d’enregistrement, l’interruption, les outils autorisés, les coûts d’une session longue et le repli lorsque le réseau se dégrade. La provenance SynthID ajoutée à l’audio compatible aide à identifier certaines sorties, sans résoudre tous les usages abusifs.
La fluidité de GPT-Live vient moins d’un modèle isolé que d’un système qui protège le chemin audio. Streaming, délégation, transfert d’état et transport rapide travaillent ensemble pour que la conversation continue pendant que l’infrastructure effectue le travail lourd.
La discussion
Commentaires
Chargement des commentaires…